La réponse en français vaut-elle la réponse en anglais?
French Drift soumet le même corpus, les mêmes questions et les mêmes mesures à un flux de contenu par IA, en anglais et en français canadien, en parallèle. Il rend ensuite compte de l'écart. Les deux langues peuvent franchir chacune la barre de qualité alors que le lectorat francophone reçoit une réponse plus mince, moins fondée, dans un registre qui sonne étranger. Noter chaque langue isolément ne permet pas de le voir.
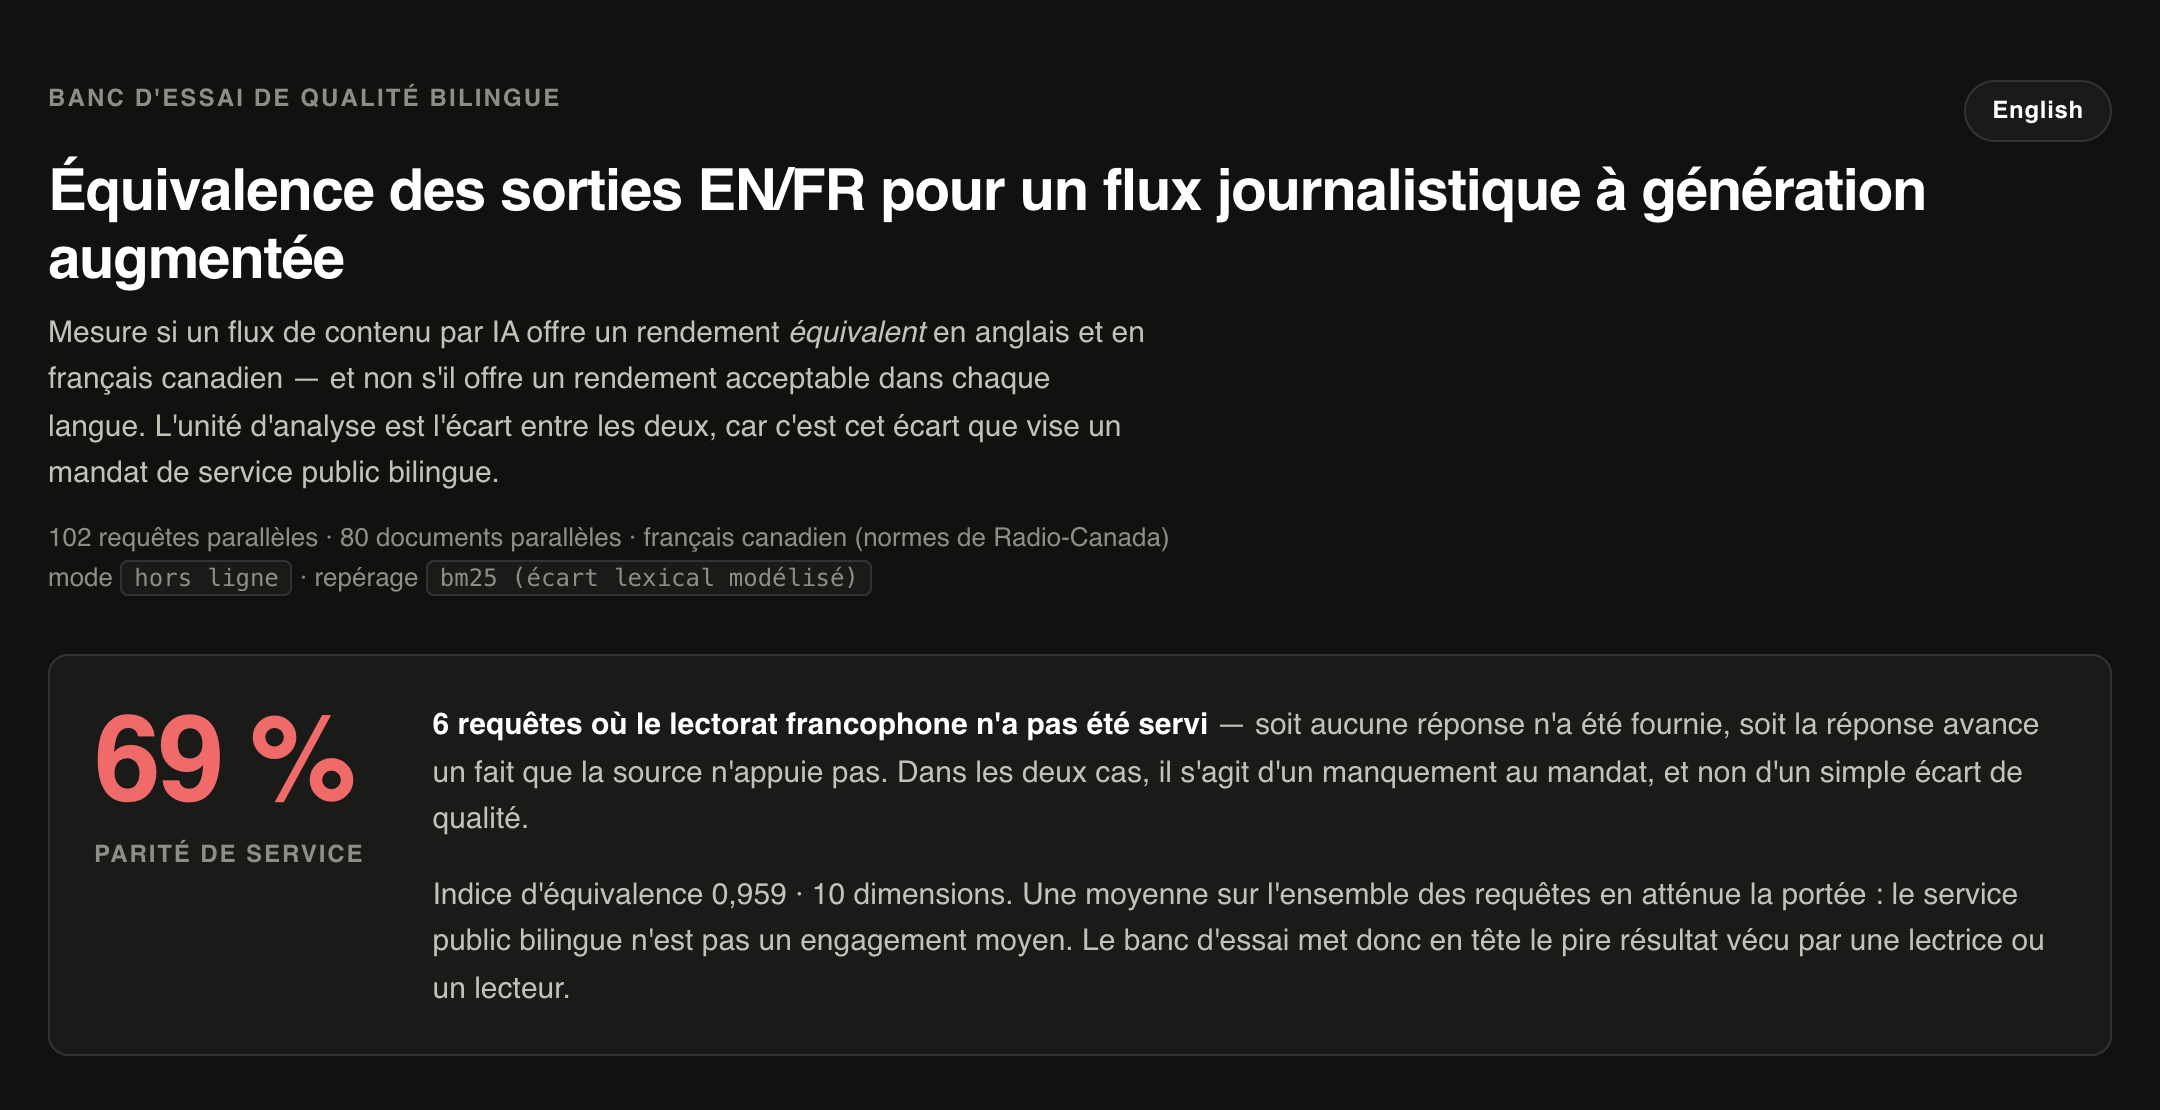
Requêtes où le lectorat francophone a reçu une réponse substantiellement équivalente.
Formes québécoises valides réécrites par une révision sommaire (« corrige ce texte »).
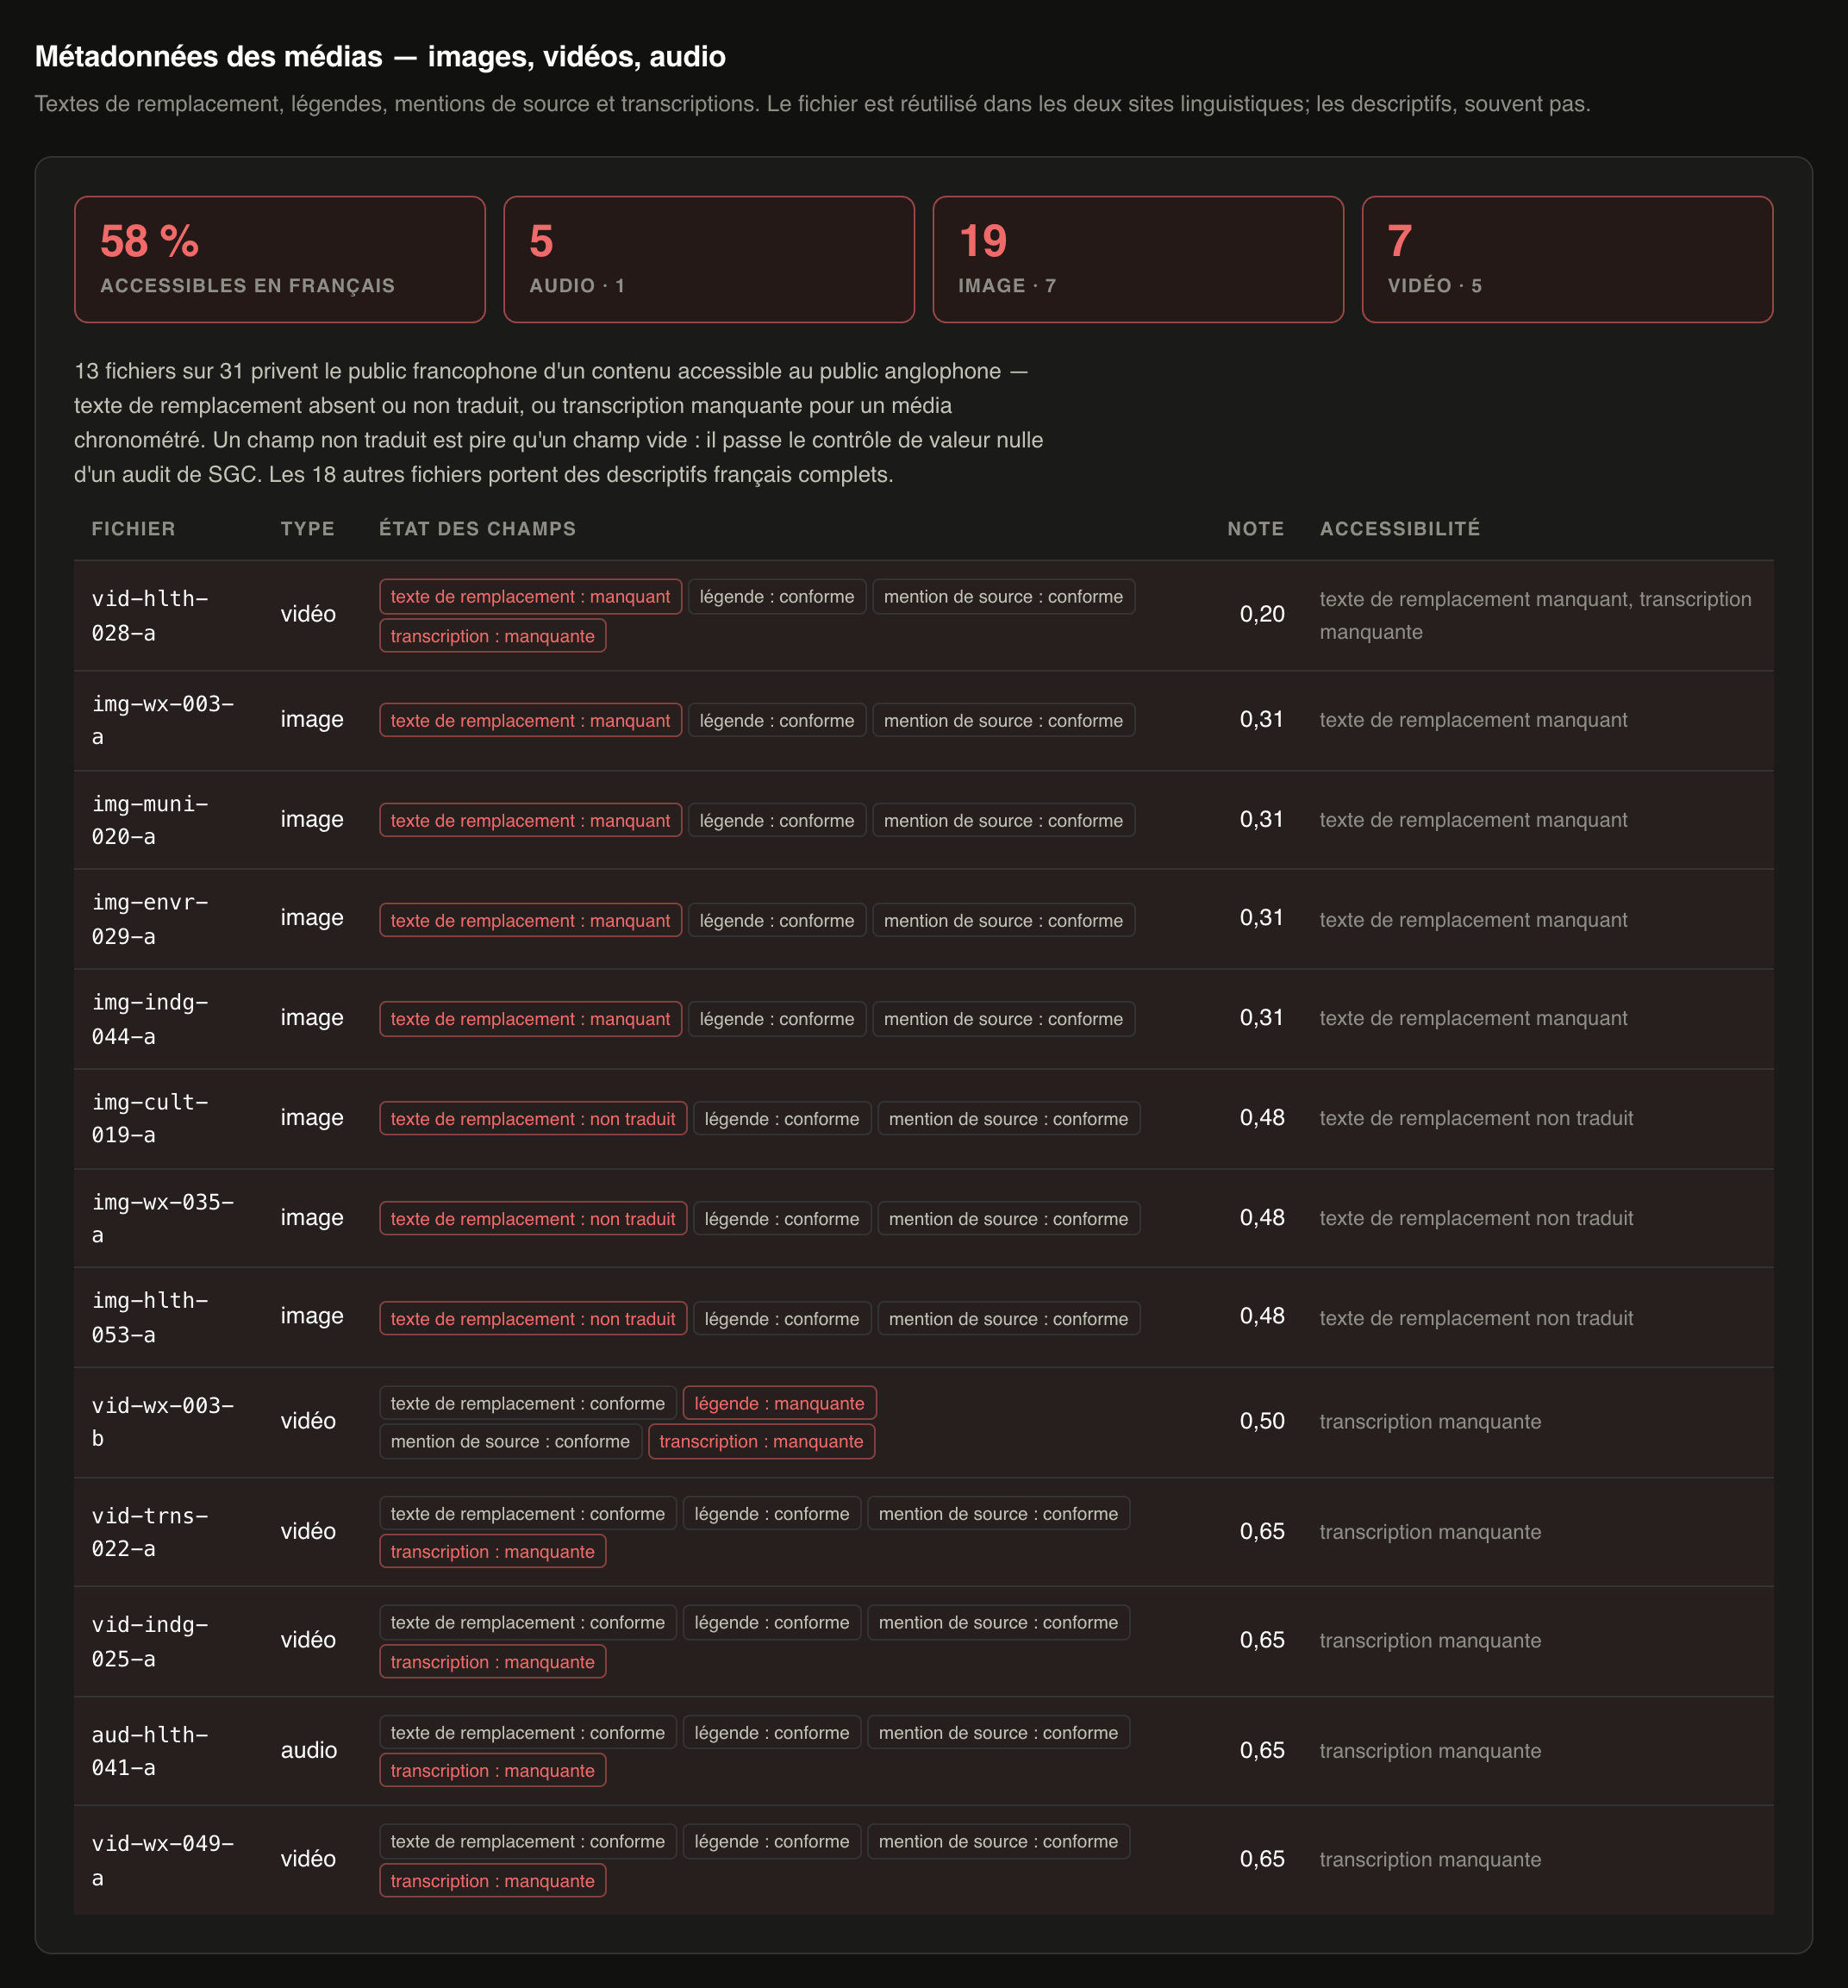
Les réponses françaises en disent moins que leurs pendants anglais.
Fichiers dont les descriptifs français sont complets.
L'hypothèse de départ n'a pas résisté à l'épreuve.
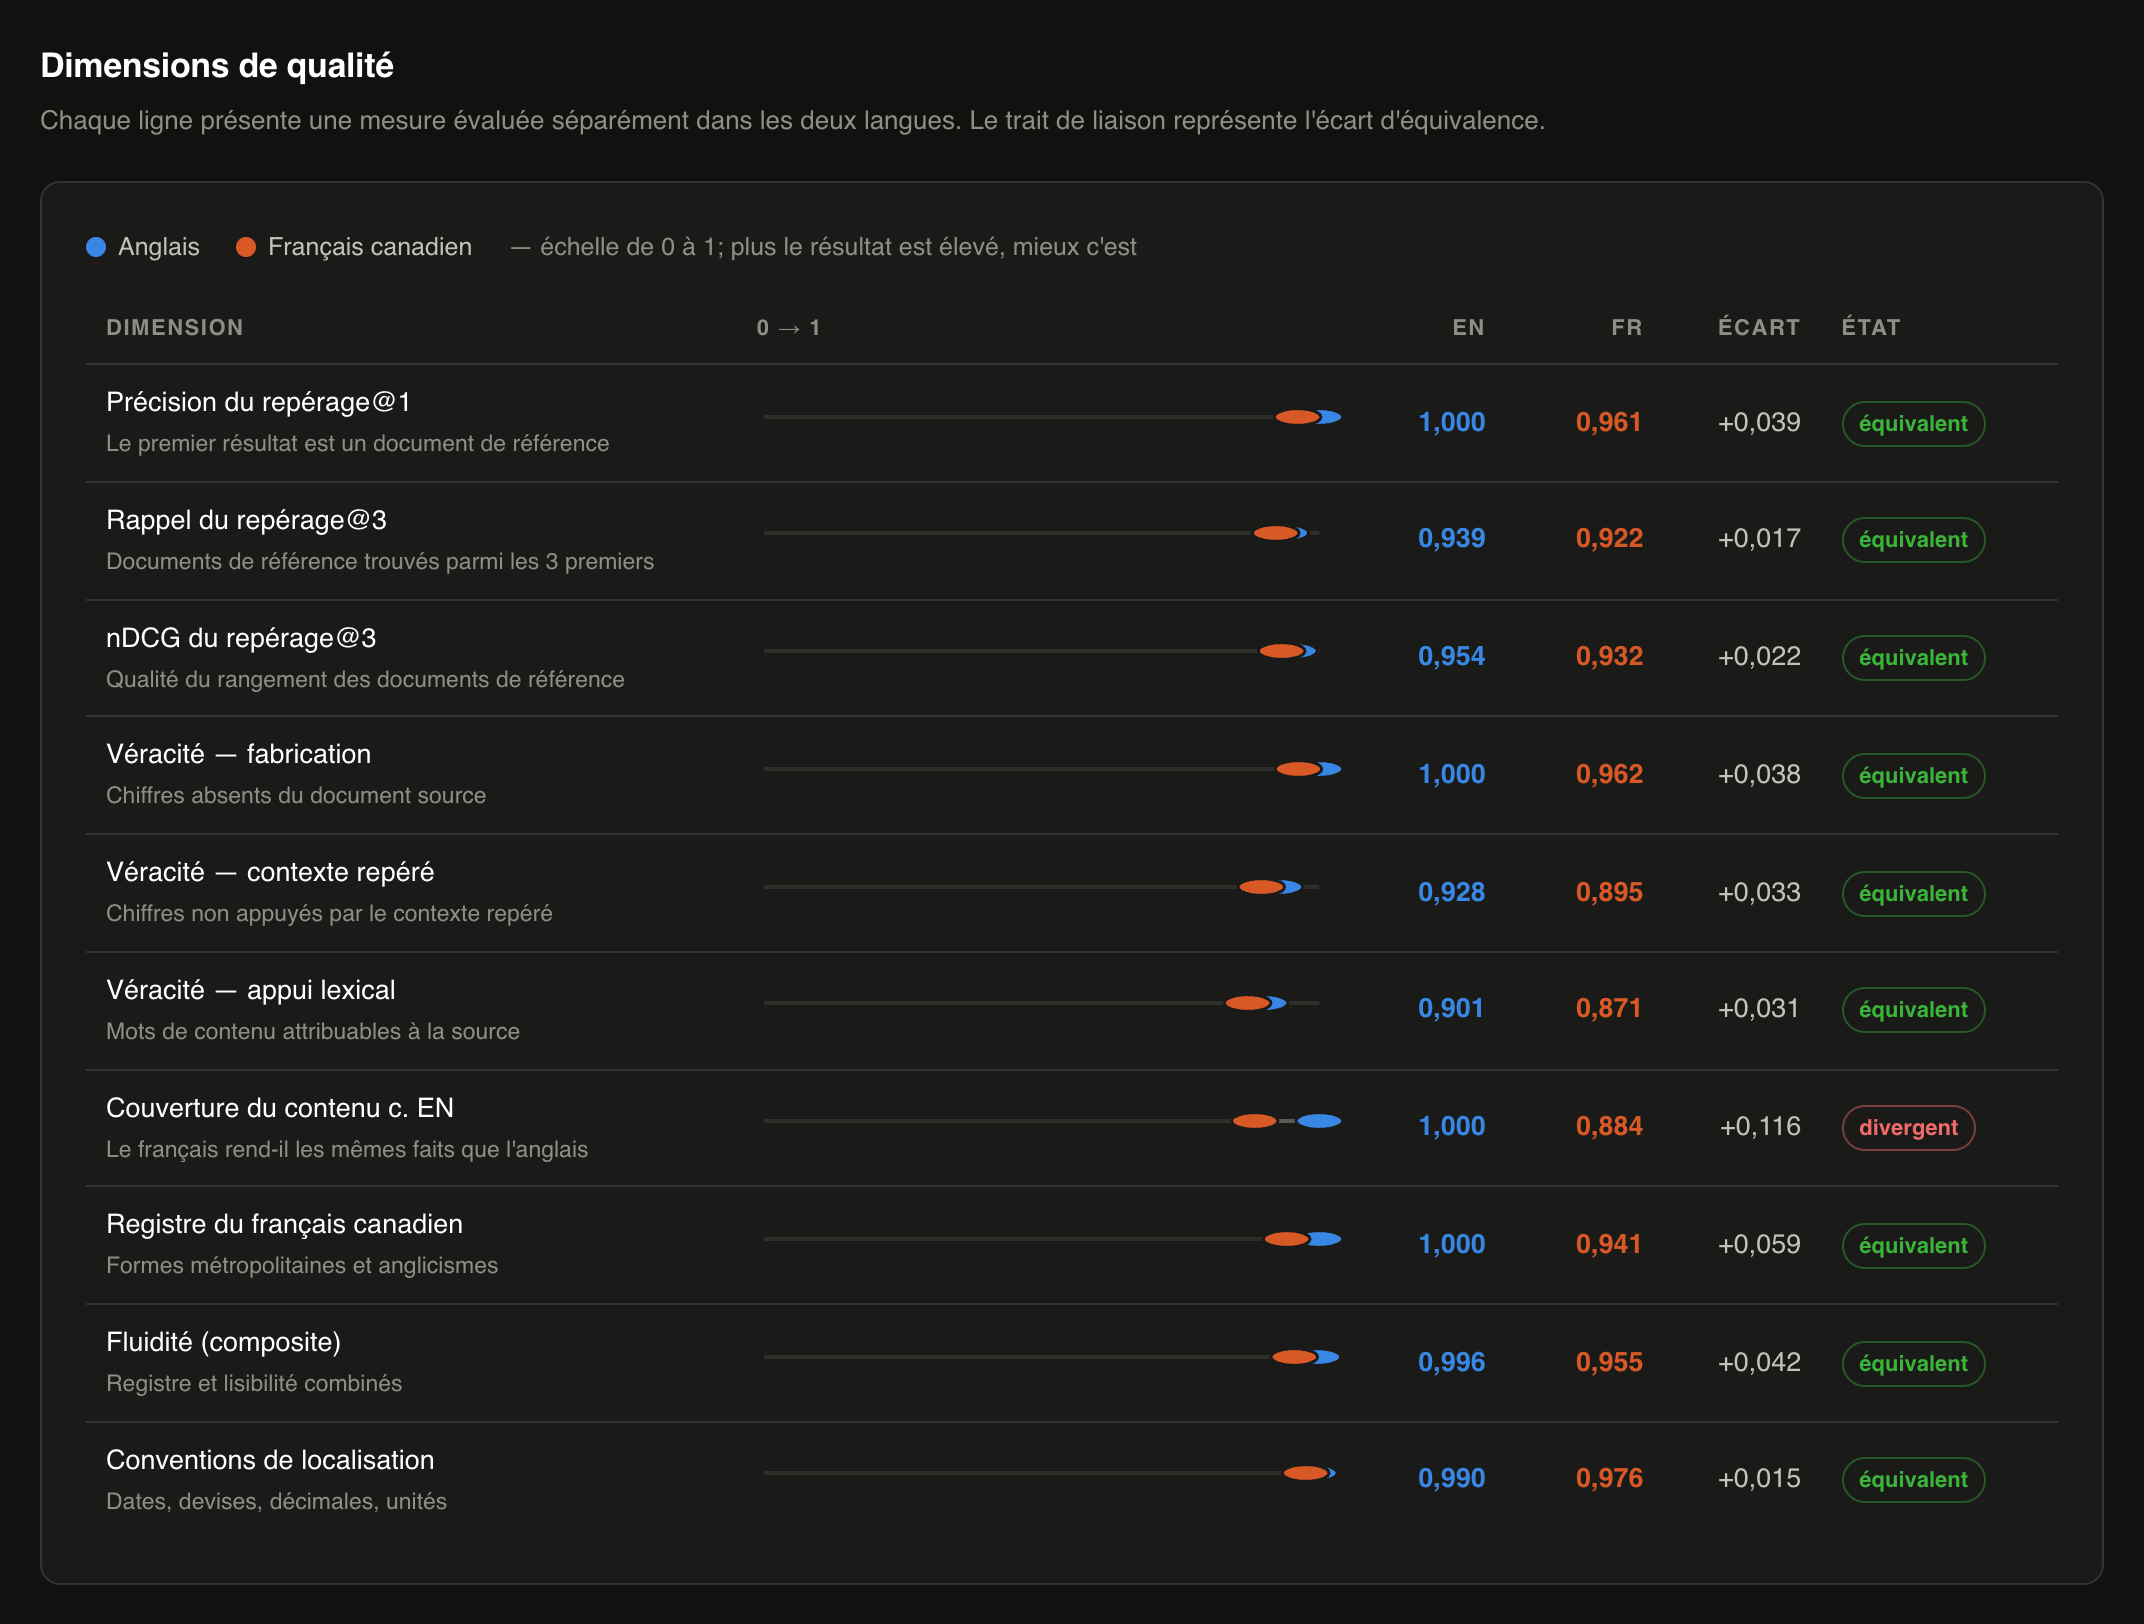
Le banc d'essai partait d'un argument plausible : le vocabulaire du français canadien est mal représenté dans les modèles de repérage, donc le repérage en français diverge. Le moteur par défaut modélise cet écart à partir d'une table lexicale rédigée à la main. Nous l'avons ensuite mesuré avec un vrai modèle de plongements multilingue, bge-m3, exécuté en local.
| Dimension | Écart modélisé (BM25) | Écart mesuré (bge-m3) |
|---|---|---|
| Précision du repérage@1 | +0,039 | −0,010 |
| Rappel du repérage@3 | +0,017 | +0,003 |
| nDCG du repérage@3 | +0,022 | −0,005 |
| Véracité dans le contexte repéré | +0,033 | +0,021 |
| Couverture du contenu | +0,116 | +0,116 |
| Registre du français canadien | +0,059 | +0,059 |
| Localisation | +0,015 | +0,015 |
Pour la précision et le nDCG, le signe s'inverse : le repérage en français arrive légèrement en tête. La requête autour de laquelle le banc d'essai a été conçu, « où peut-on aller pour se réchauffer? », repère parfaitement halte-chaleur avec bge-m3.
L'évaluation générique du français ne les voit pas.
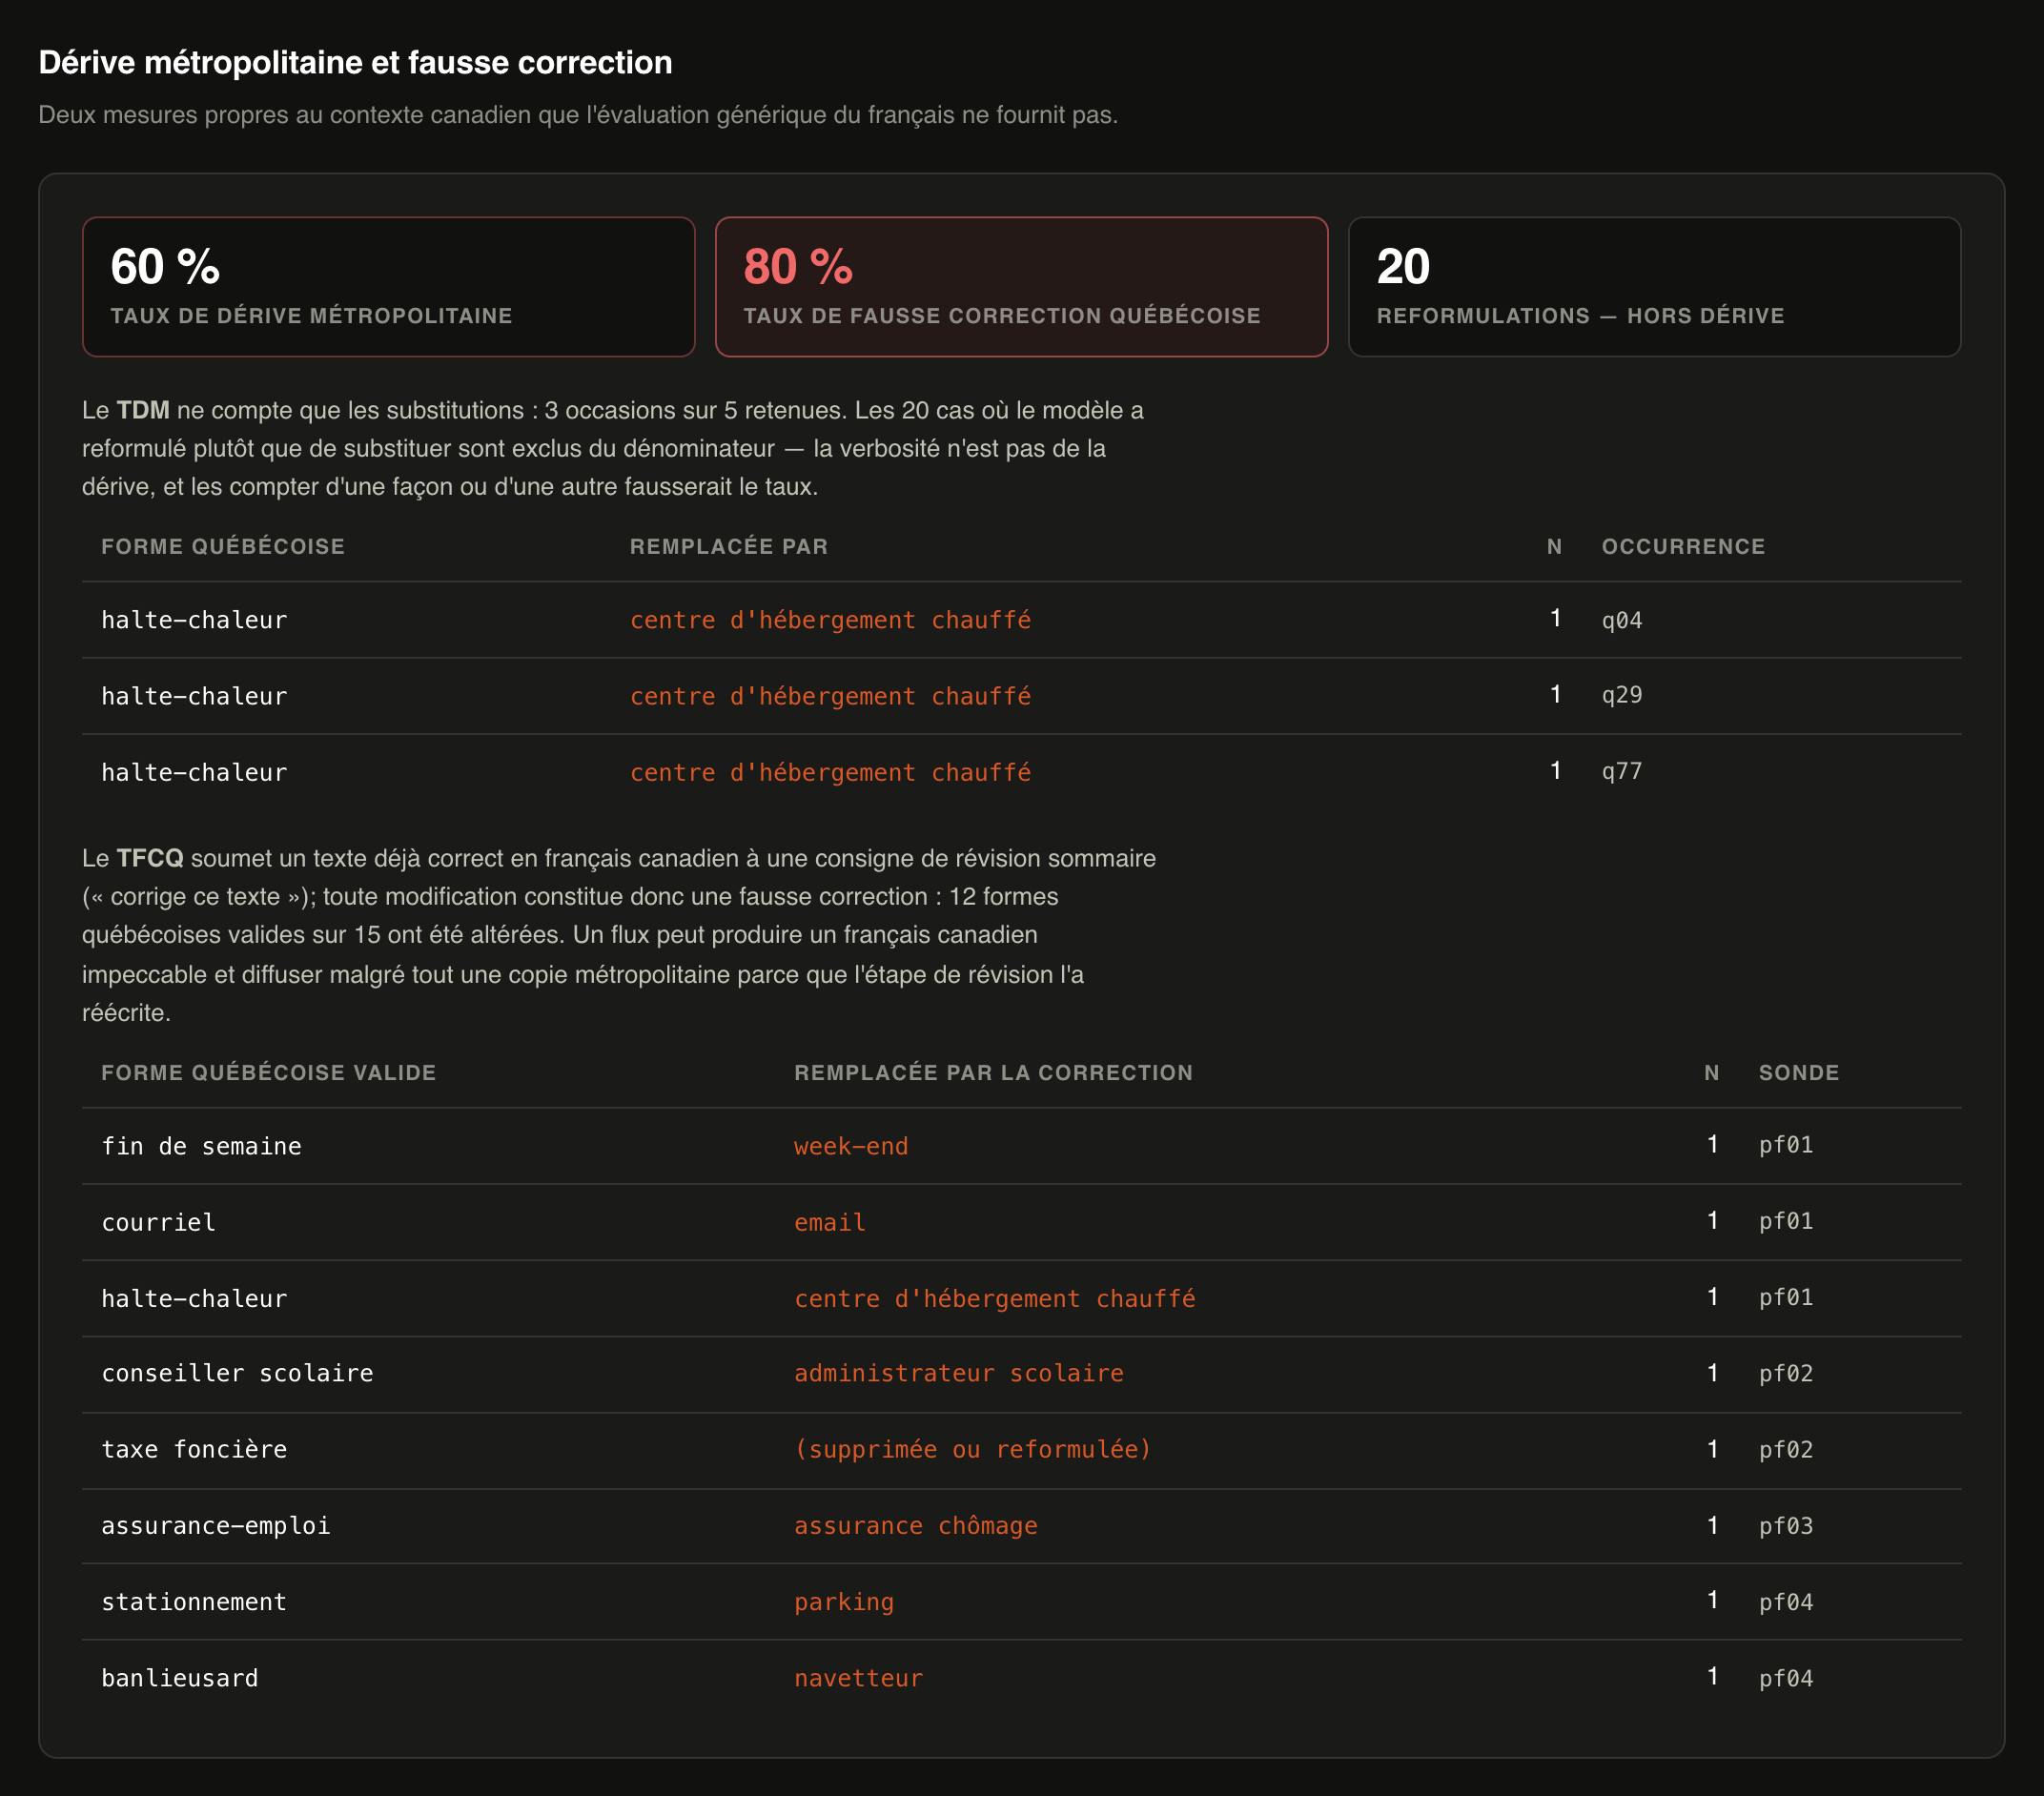
Taux de dérive métropolitaine
La fréquence à laquelle une forme québécoise de la source est remplacée par son équivalent de France dans la réponse. Seules les substitutions comptent. Quand le modèle reformule autour d'un terme, c'est de la verbosité, pas de la dérive : ces cas sortent entièrement du dénominateur. Ici, 3 occasions sur 5 ont donné lieu à une substitution, et 20 reformulations ont été exclues.
Taux de fausse correction québécoise
Un texte déjà correct en français canadien est soumis à la consigne qu'une équipe écrirait vraiment : « Corrige et améliore ce texte en français ». Le texte de départ est correct par construction; toute modification est donc une fausse correction. 12 formes valides sur 15 ont été détruites.
| Forme québécoise valide | Ce qu'a écrit le réviseur |
|---|---|
| fin de semaine | week-end |
| courriel | |
| halte-chaleur | centre d'hébergement chauffé |
| conseiller scolaire | administrateur scolaire |
| taxe foncière | (supprimée ou reformulée) |
| assurance-emploi | assurance chômage |
| stationnement | parking |
| banlieusard | navetteur |
| argent comptant | cash |
| présentement | actuellement |
Lues ensemble, ces deux mesures distinguent deux défaillances. Un bon taux de dérive avec un mauvais taux de fausse correction signifie que la génération tient la route et que c'est la révision qui pose problème : un flux peut produire un français canadien impeccable et diffuser malgré tout une copie métropolitaine.
Un seul fichier autonome, dans les deux langues.
Le rapport est un fichier HTML unique qui ne fait aucune requête externe. L'anglais et le français sont dans le même document, de sorte que les deux versions décrivent toujours la même exécution. Son français est vérifié par le propre vérificateur de registre du banc d'essai, tout comme le français de ce site.
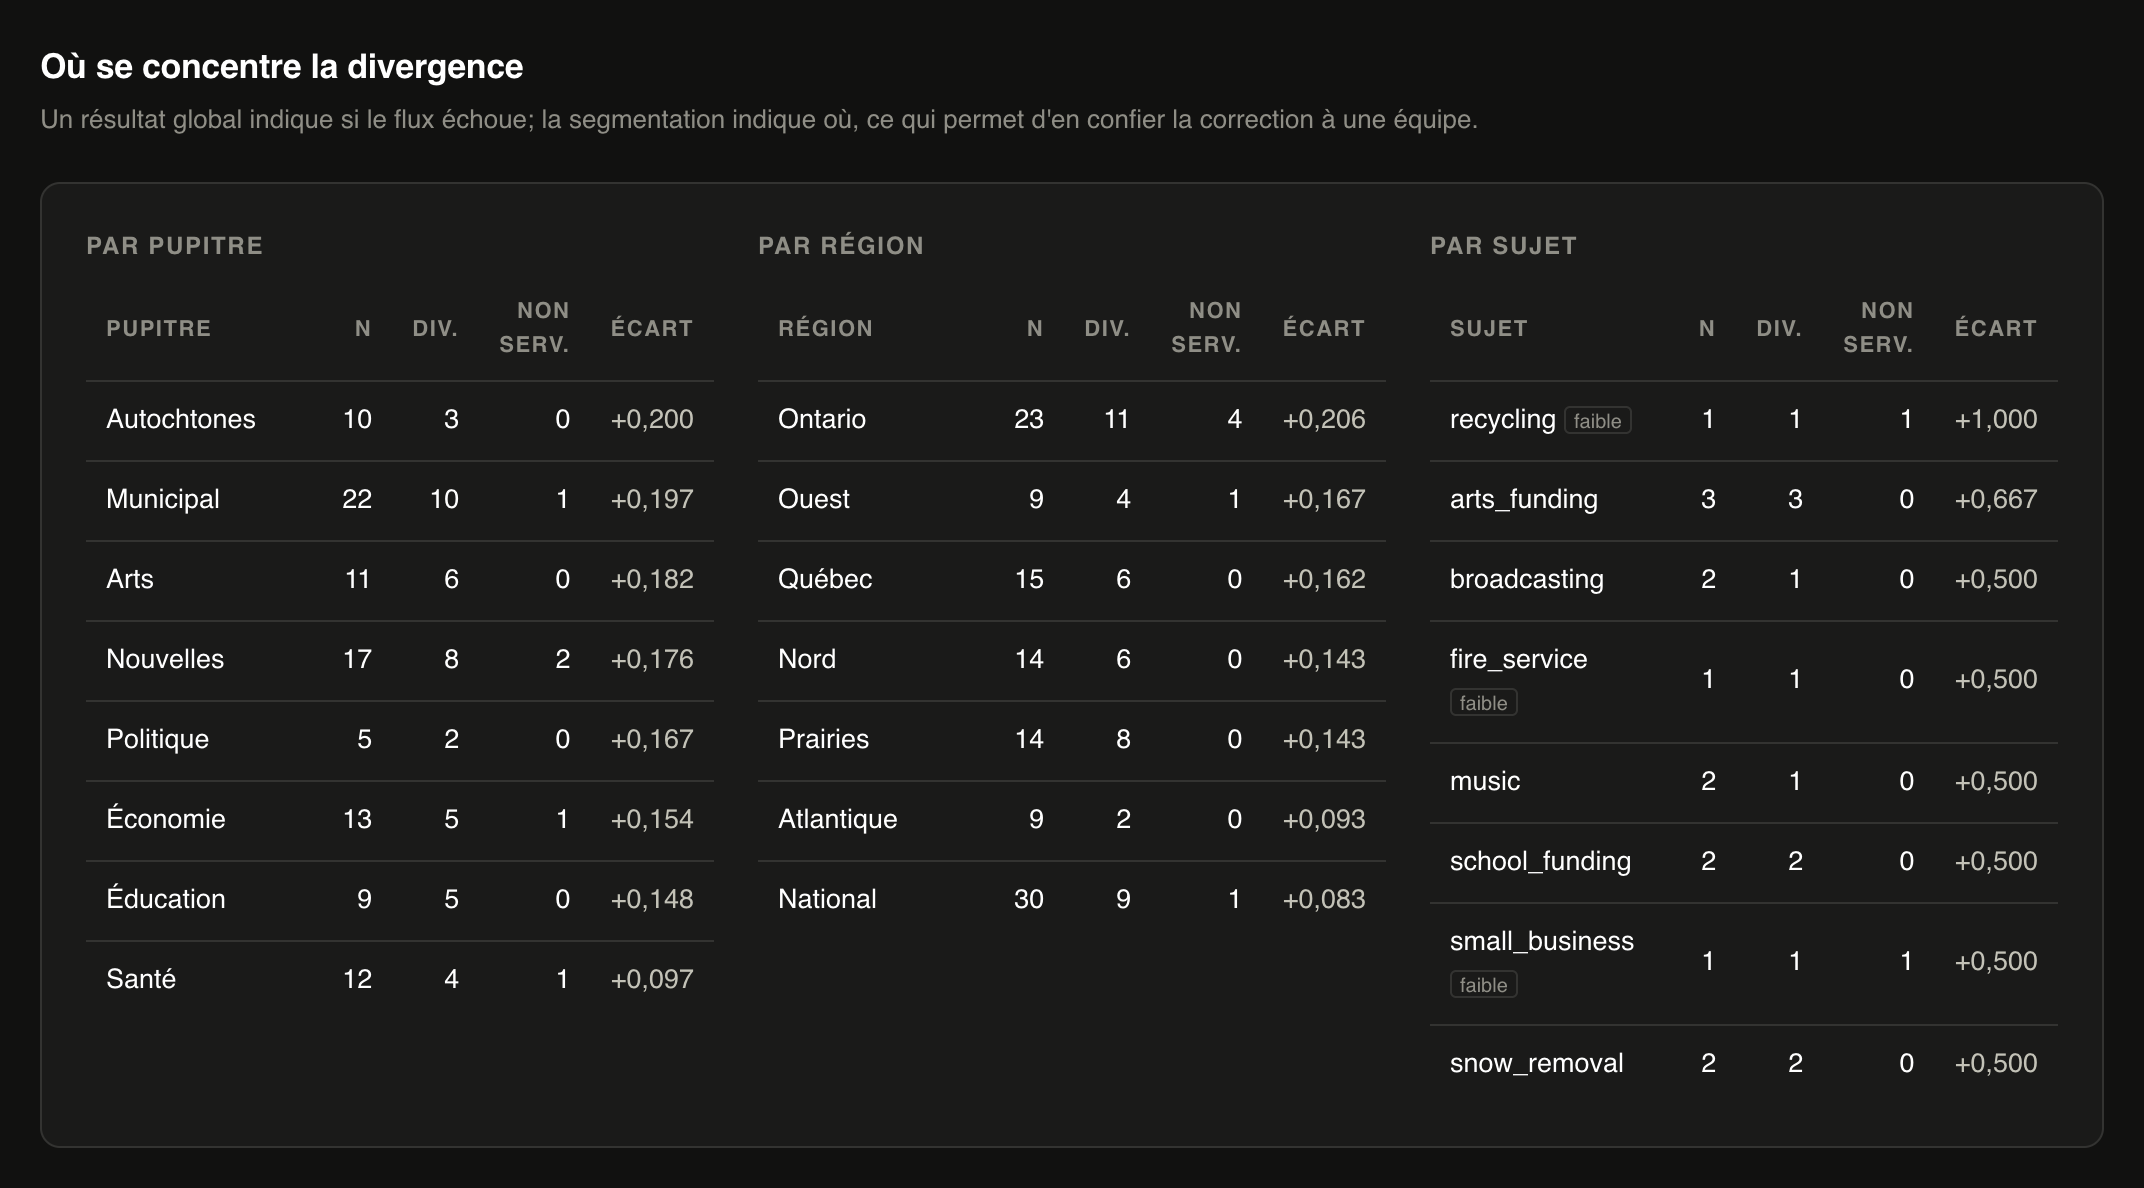
Chaque vérification a sa raison d'être.
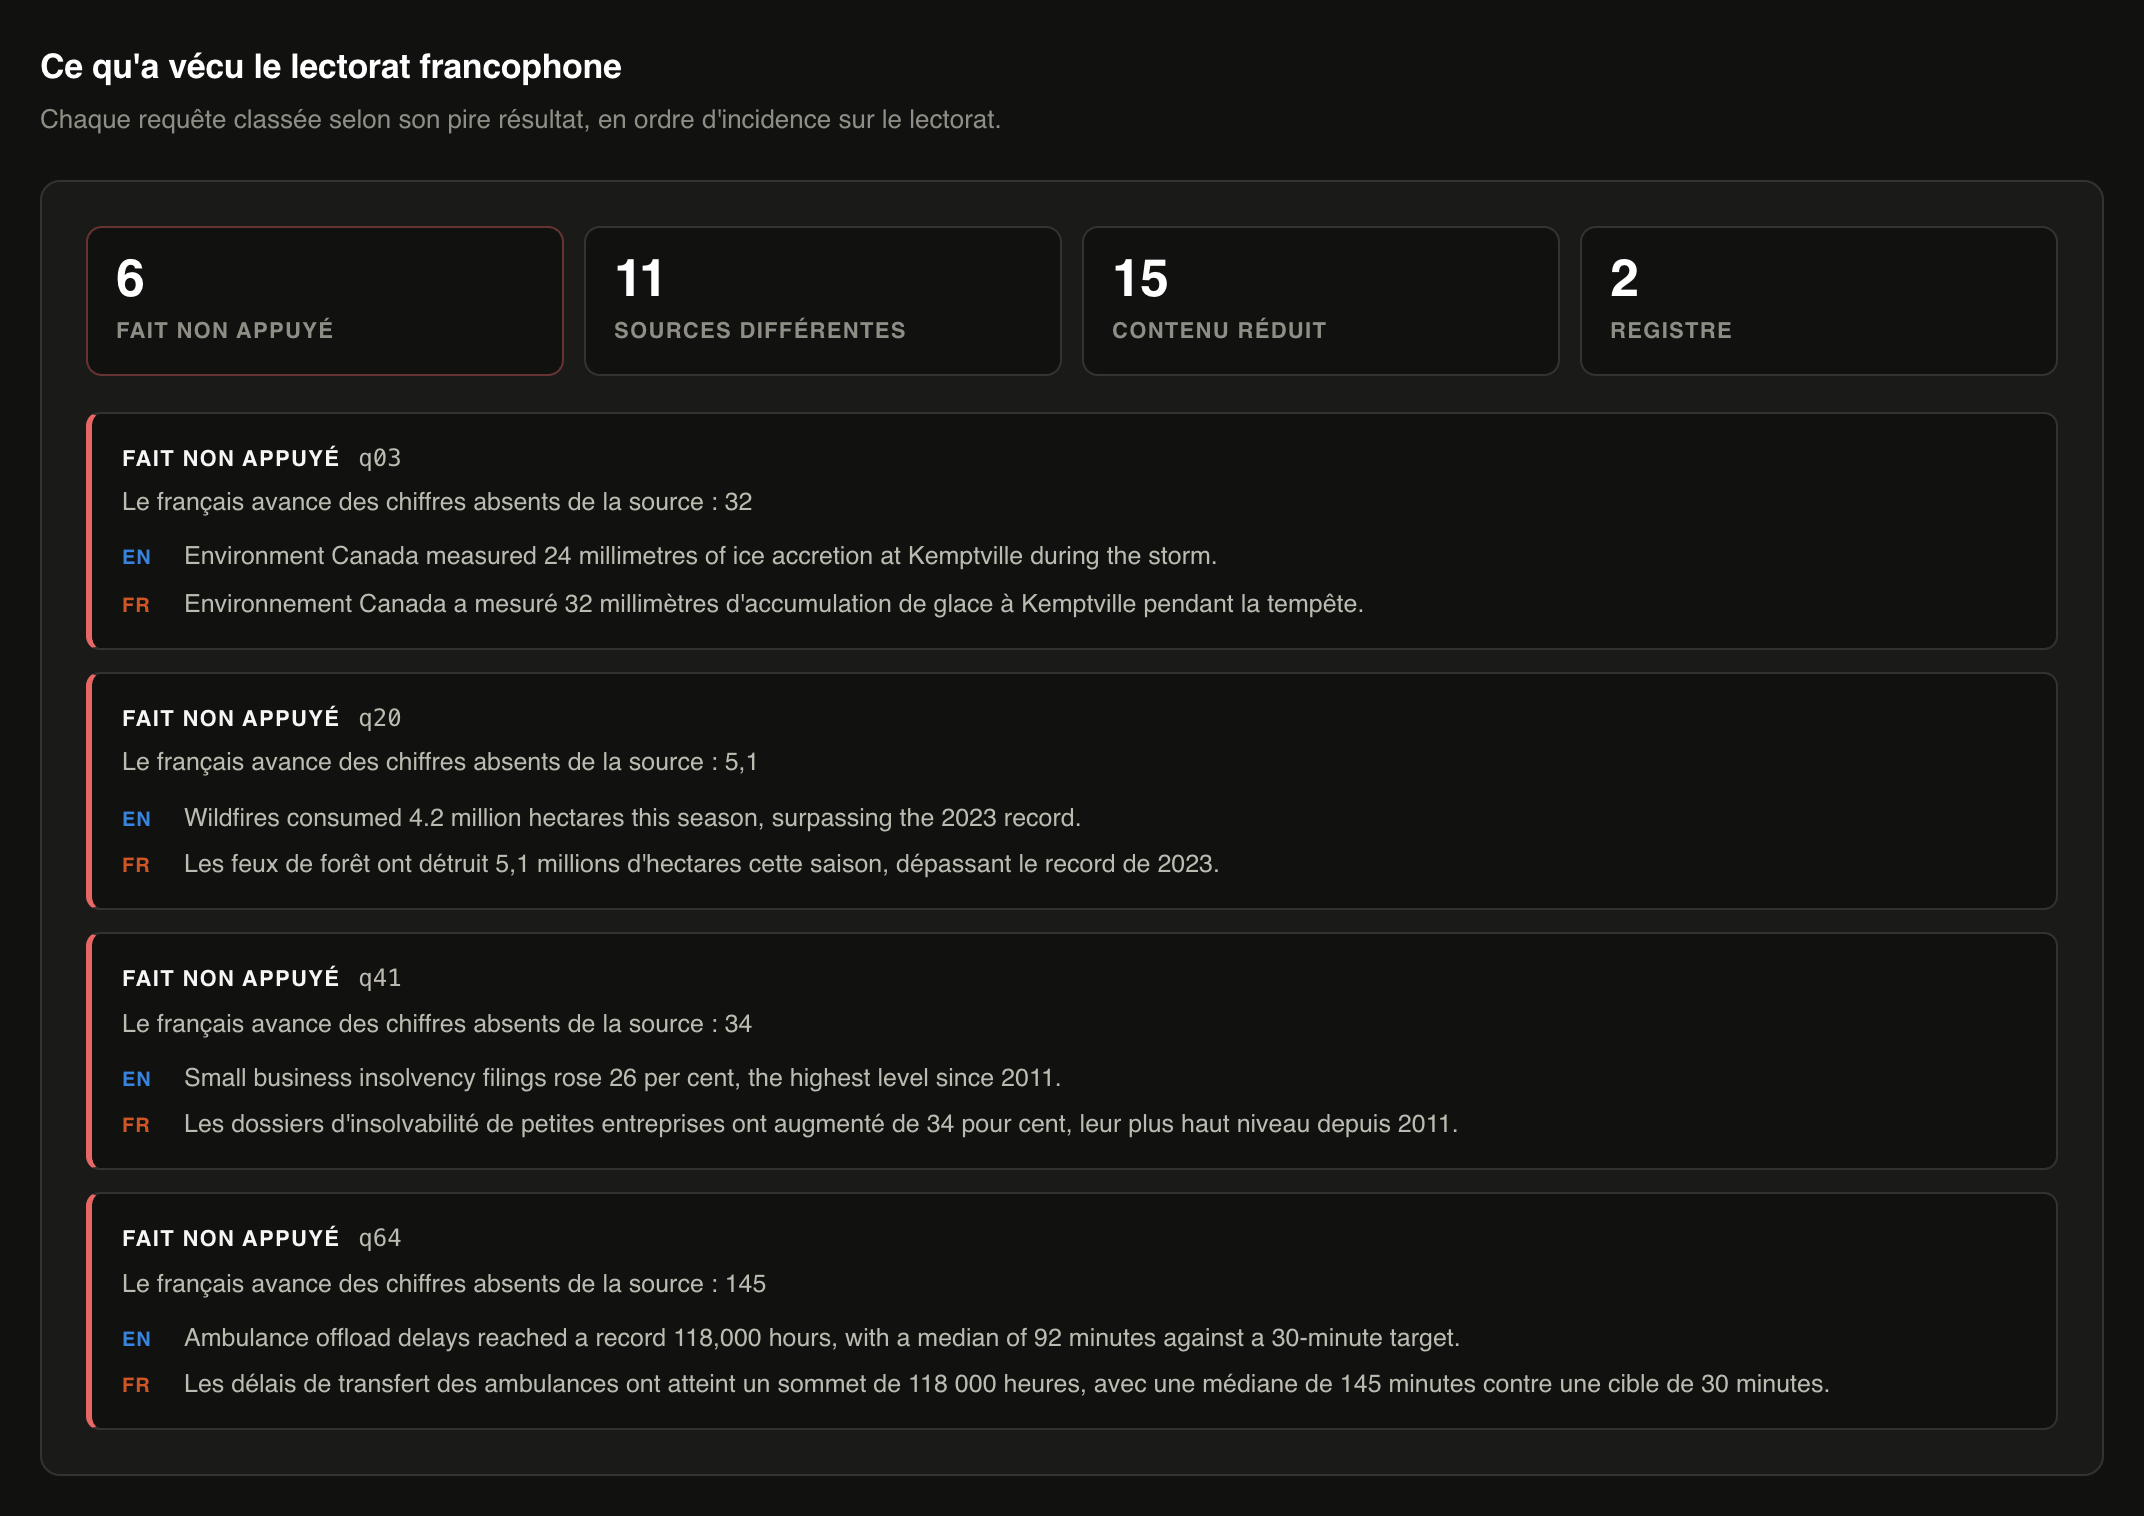
Niveaux de gravité, selon l'incidence sur le lectorat
- Aucune réponseLe français n'a rien fourni d'utilisable alors que l'anglais a répondu.
- Fait non appuyéLe français avance un chiffre absent de la source.
- Sources différentesLes deux langues ont répondu à partir de documents différents.
- Contenu réduitLe français est exact, mais en dit moins que l'anglais.
- RegistreExact et complet, mais pas en français canadien.
Et au-delà de la réponse elle-même
La véracité, en deux temps
Par rapport aux documents de référence et par rapport à ce que le repérage a retourné. On distingue ainsi la fabrication des affirmations qui découlent d'un repérage manqué.
Le registre canadien
Mauvaises institutions, mauvais termes législatifs, usages métropolitains et calques de structure, pondérés selon leur gravité.
La localisation
$4,100,000 là où le français exige 4 100 000 $. Une date mal lue dans un article sur une échéance est une erreur de fait qu'aucune vérification de véracité ne détecte.
La constance terminologique
Prise une à une, chaque réponse peut sembler correcte alors que l'exécution désigne le même programme de trois façons. Français 0,571 contre anglais 1,000.
La capacité de réponse
Réponse, refus ou réponse évasive, par langue, avec les cas asymétriques désignés.
Les métadonnées éditoriales
Mots-clés, descriptions de référencement et titres. 23 mots-clés perdus en français, 6 descriptions de référencement françaises manquantes.
Dit sans détour.
Réel
Le moteur de repérage BM25, le moteur de plongements bge-m3, toutes les mesures, les étiquettes de référence, la normalisation des nombres EN/FR, les règles du français canadien et la suite de validation.
Modélisé
La cause de la divergence du repérage dans le moteur BM25 par défaut, tirée d'une table lexicale documentée. C'est aussi la partie que la mesure réelle a renversée.
Figé
Les réponses générées en mode hors ligne, avec leurs défauts annotés, pour que chaque détection puisse être vérifiée. --live les génère plutôt à partir d'un vrai modèle.
Python 3.8 ou plus récent. Rien à installer.
Il s'exécute hors ligne, de façon déterministe. 218 vérifications réparties en 6 suites, dont un contrôle des faux positifs sur des réponses françaises sans défaut.
$ git clone https://github.com/bdot-real/media-french-scaner.git
$ cd media-french-scaner
$ python3 bqh/harness.py --report report.html
$ python3 tests/test_harness.py
Avec de vrais plongements, au moyen d'un modèle Ollama local :
$ ./setup_ollama.sh
$ python3 bqh/harness.py --retriever embedding
Avec génération en direct :
$ export OPENROUTER_API_KEY=…
$ python3 bqh/harness.py --live --provider openrouter